152026·09
梅森旋转算法为什么是游戏开发者的最爱?周期、速度与局限性全解析深度 · 算法原理
从 MT19937 的状态矩阵到高维均匀性,讲清楚为什么它在游戏和科学计算中几乎无可替代,以及它在密码学上的致命弱点。
👁 8,240 次浏览 · ❤️ 312 收藏 · ⏱ 阅读约 9 分钟
从「为什么需要真随机」切入,系统拆解随机数生成器的原理、分类、安全性与实用场景,普通用户和开发者都能找到最合适的工具。
以上参数来源于公开技术文档,仅供参考,实际数值因实现版本而异。
一句话先说结论:随机数生成器是一种能产生「看起来没有规律」的数字序列的机制,但「看起来没规律」和「真的没规律」是两回事,这个区别决定了你该用哪类工具。
你掷一颗六面骰子,得到 1 到 6 之间某个数,这就是最原始的随机数生成过程。骰子的物理不确定性保证了结果的不可预测性。随机数生成器(Random Number Generator,简称 RNG)做的事情本质上一样,只是把「掷骰子」这个物理动作换成了计算机能执行的算法或硬件机制,产生的是数字序列而非骰子点数。
在计算机里,随机数生成器分两大类:一类依赖真实的物理随机过程(比如硬件噪声、大气噪声),叫做真随机数生成器(TRNG);另一类用数学公式从一个初始值(种子)出发推算出一长串数字,这串数字统计上「看起来随机」,叫做伪随机数生成器(PRNG)。两类各有优劣,后面会详细比较。
对于伪随机数生成器,工作逻辑大致是这样的:给它一个初始值(种子,seed),它用一套固定的数学变换公式反复计算,每次计算产生一个新数字,同时把当前状态更新为下一次计算的输入。整个过程像一条流水线,种子是原料,公式是机器,输出的是一串数字。因为公式是固定的,只要种子相同,每次运行产生的序列完全一样——这个特性在科学实验里很有用,但在密码学里是致命弱点。
真随机数生成器则不依赖数学公式,而是采集真实世界的物理随机信号:比如 random.org 采集大气无线电噪声,Linux 系统的 /dev/random 收集鼠标移动、键盘敲击、磁盘 I/O 等硬件事件的时间差作为熵源。这些物理过程在理论上是不可预测的,因此产生的数字也是真正意义上的随机。
计算机本质上是确定性机器——给定相同输入,永远产生相同输出。这意味着纯软件算法无法产生「真正的」随机数,只能产生「统计上足够随机」的伪随机数。这个限制不是工程缺陷,而是图灵机模型的根本特性。正因如此,密码学家们花了几十年时间研究如何让伪随机数「足够好用」,同时也在寻找更好的硬件熵源来弥补软件的不足。现代操作系统通常把两者结合:用硬件噪声作为初始种子,再用高质量的密码学伪随机数生成器(CSPRNG)扩展输出,兼顾了安全性和速度。
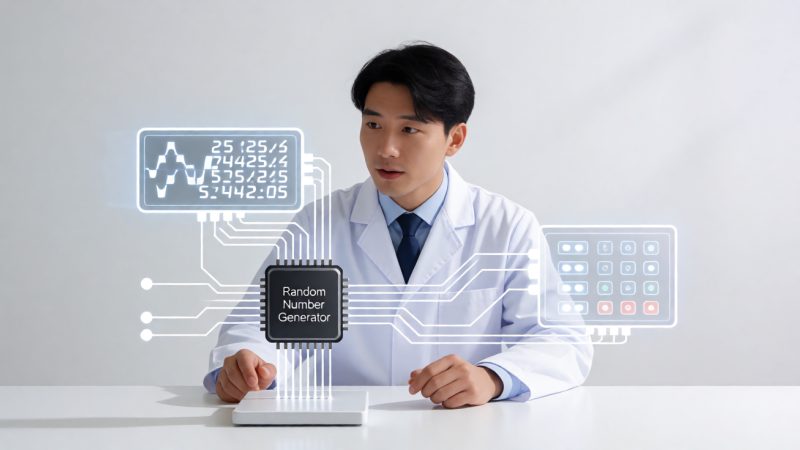
一句话先说结论:真随机数来自物理不确定性,不可预测也不可复现;伪随机数来自数学公式,速度快但理论上可被预测——日常抽签用伪随机够用,密码学场景必须用真随机或密码学级伪随机。
真随机数(True Random Number,TRNG)的熵来自物理世界:大气噪声的电压波动、放射性衰变的时间间隔、光子通过半透镜的路径选择……这些过程在量子力学层面是本质随机的,没有任何已知方法可以预测。random.org 采集的就是大气无线电噪声,每秒钟能产生约 127,000 bit 的随机数据,每个免费账户每天有约 1 兆比特(1M bit)的免费配额。
伪随机数(Pseudo-Random Number,PRNG)则完全是数学游戏。给定种子 S,算法 F 计算出 F(S)=R₁,再用 R₁ 计算 F(R₁)=R₂,如此循环。这个序列在统计检验上通过「随机性」测试,但只要知道算法和种子,就能完整预测整个序列。梅森旋转算法(MT19937)只需观察 624 个连续输出值,就能完全恢复内部状态,进而预测后续所有输出——这在密码学上是灾难性的弱点。
伪随机数生成器的速度优势非常显著。在普通笔记本电脑上,Python 的 random 模块(基于 MT19937)每秒能生成约 1000 万个随机整数;而真随机数受限于物理熵源的采集速度,通常每秒只能稳定产生数千到数万个随机数。如果你需要在游戏中每帧生成大量随机数,或者在科学模拟中跑蒙特卡洛算法需要数百万个样本,真随机数的速度根本跟不上需求,伪随机是唯一实际可行的选择。
但真随机数在某些场景下不可替代。生成 SSL/TLS 证书的私钥、产生一次性密码(OTP)、抽取大型活动的奖项……这些场景一旦使用了可预测的伪随机数,攻击者就可能在不暴力破解的情况下推算出结果,造成安全事故。2012 年曾有研究发现,部分 RSA 密钥因使用了低质量随机数生成器导致私钥可被恢复,这不是理论漏洞,是真实发生过的事故。
• 可被预测(知道种子即可)
• 周期有限(MT19937 周期虽大但有限)
• 不适合密码学、彩票等高安全场景
• 种子选择不当(如用时间戳)会大幅降低安全性
• 不可预测、不可复现
• 熵来自物理过程,理论上无法破解
• 适合密码学密钥生成、重大抽奖
• 缺点:速度慢、需要硬件支持或网络服务
| 场景 | 推荐类型 | 理由 |
|---|---|---|
| 日常抽签抽号 | 高质量伪随机 | 速度快,统计公平,够用 |
| 游戏随机地图/掉落 | 伪随机(可复现) | 需要种子复现,调试方便 |
| 科学蒙特卡洛模拟 | 高质量伪随机 | 需要大量样本,速度优先 |
| 密码/密钥生成 | 密码学级随机(CSPRNG) | 必须不可预测,安全第一 |
| 大型活动公开抽奖 | 真随机(有公证需求) | 公信力要求高,可审计 |
| 加密货币私钥 | 硬件真随机(TRNG) | 最高安全级别要求 |
梅森旋转算法(Mersenne Twister,MT19937)由松本真和西村拓士于 1998 年提出,是目前使用最广泛的伪随机数生成器算法之一。Python 的 random 模块、Ruby、PHP、MATLAB 等众多语言和工具的默认随机数生成器都是 MT19937。它的名字来源于其周期长度:2^19937 - 1,这是一个梅森素数。
MT19937 内部维护一个 624 个 32 位整数组成的状态数组,每次生成随机数时从这个数组中取值并进行一系列位运算(旋转、异或、移位)。它通过了大多数统计随机性检验,在均匀性、周期长度和高维均匀分布方面表现优秀。但它有两个关键弱点:第一,观察 624 个连续输出就能完全恢复内部状态;第二,它不是密码学安全的,不应用于生成密码、密钥或任何安全敏感的随机数。
线性同余生成器(Linear Congruential Generator,LCG)是最古老也是最简单的伪随机数生成器,公式是 X(n+1) = (a × X(n) + c) mod m,其中 a、c、m 是固定参数,X(0) 是种子。这个公式一眼就能看出问题:输出的数字最多只有 m 种可能,周期最长为 m,通常参数选择不当时周期更短。Java 的 java.util.Random 类就是基于 LCG 的变体,周期为 2^48,这意味着只需要观察少量输出就能预测后续所有值。
LCG 的优点是实现极简、速度极快,缺点是随机质量差,不适合高维统计模拟(高维空间中会出现明显的超平面结构,这被称为「马斯利亚效应」)。如果你看到某个老旧工具生成的随机数在散点图上呈现规律性条纹,很可能就是 LCG 的锅。
现代 CPU 通常内置了硬件随机数生成单元。Intel 和 AMD 的处理器从 2012 年前后开始提供 RDRAND 指令,直接从硬件热噪声(电阻热噪声)中采样随机数。ARM 架构的芯片(包括手机 SoC)也有类似的硬件熵源。操作系统层面,Linux 的 /dev/random 和 /dev/urandom、Windows 的 CryptGenRandom、macOS 的 SecRandomCopyBytes 都会混合多种硬件熵源(CPU 指令、中断时序、硬件计数器等)来产生高质量的随机数种子。
random.org 走了另一条路:通过无线电接收大气噪声信号,对信号进行采样和去偏处理,产生真随机比特流。大气噪声来自全球的雷电活动和宇宙射线,理论上不可预测。这种方式产生的随机数质量极高,但受限于信号采集速度,每秒产生量有限,这也是它设置每日配额的原因。
CSPRNG(Cryptographically Secure Pseudo-Random Number Generator)是专门为密码学设计的伪随机数生成器,要满足两个核心安全要求:向前不可预测性(知道过去的输出无法预测未来)和向后不可预测性(知道当前状态无法推算历史输出)。常见的 CSPRNG 包括基于 AES-CTR 的实现、ChaCha20 流密码、以及 NIST 推荐的 Hash_DRBG 和 HMAC_DRBG。Python 的 secrets 模块、JavaScript 的 crypto.getRandomValues()、Java 的 SecureRandom 都是 CSPRNG 的封装,用于密码学场景时应优先选择这些而非普通的伪随机数函数。
即将上线 — 用动画演示梅森旋转、LCG 与真随机熵源的工作过程,适合零基础理解算法逻辑。预计时长约 18 分钟。
一句话先说结论:普通伪随机数生成器不适合密码学场景——日常抽签够用,但生成密码、密钥、Token 必须用 CSPRNG 或真随机,否则攻击者可能在不暴力破解的情况下直接预测结果。
使用在线随机数生成器时,你的请求(包括生成的范围、数量、IP 地址)会发送到第三方服务器。主流工具如 random.org 在其隐私政策中明确说明会记录请求日志用于系统运营,但承诺不会出售用户数据。对于日常抽签、抽号等低敏感场景,这个风险完全可以接受。但如果你打算用在线工具生成密码、API 密钥、加密盐值,就要三思了——你不仅要信任这个服务的安全性,还要信任它的网络传输链路没有被中间人截获。
更安全的做法是使用本地生成方案:浏览器内置的 crypto.getRandomValues() 在本地运行,不发送任何数据到服务器;操作系统的随机数接口(Linux /dev/urandom、Windows CryptGenRandom)同样完全本地化。对于密码生成,建议优先使用这类本地 CSPRNG,而非依赖在线服务。
伪随机数生成器的安全性完全依赖种子的不可预测性。如果攻击者能猜到种子,就能重现整个随机数序列。历史上最常见的错误是用时间戳(如 Unix 时间戳,精度到秒或毫秒)作为种子——在某个已知时间窗口内,攻击者只需枚举有限的时间戳值就能破解。2006 年的 Debian OpenSSL 漏洞是一个更极端的例子:由于一个错误的代码修改,OpenSSL 的随机数种子只剩下进程 ID 这一个来源(Linux 上 PID 最大约 32768),导致生成的所有密钥都可以在几分钟内枚举破解,影响了大量 SSH 密钥和 SSL 证书。
正确的做法是:永远不要自己手动指定种子用于安全场景;让操作系统或语言的 CSPRNG 自动管理种子;如果确实需要手动设置种子(比如科学实验的可复现性),在代码注释中明确标注「此种子仅用于实验复现,不得用于安全场景」。
以下场景必须使用 CSPRNG 或真随机数,使用普通伪随机数会带来真实的安全风险:生成密码或密码哈希的盐值(salt);生成 API 密钥、OAuth Token、Session ID;生成 SSL/TLS 证书的私钥;生成加密货币钱包的私钥;生成一次性密码(TOTP/HOTP)的密钥;以及任何需要「攻击者无法预测」的随机令牌。相比之下,以下场景用普通伪随机数完全够用:班级抽签、抽奖号码、随机排列顺序、游戏随机事件、数据模拟实验(需要复现时还应主动设置种子)。
以下评测基于公开功能说明与实际操作体验,评分为综合参考,不代表官方立场。各工具的隐私政策、服务条款以其官网最新版本为准。
以上评分为编辑综合评估,数据以各工具官方文档为准,实际体验可能因版本更新而变化。
耗时:约 5 分钟 · 难度:零基础可完成 · 工具:任意浏览器
统计参与抽签的总人数,给每个人分配一个唯一编号(通常直接用 1 到 N)。如果已有花名册,按顺序编号即可。20 人以内建议 1-20,超过 100 人时建议提前准备好编号对照表,避免现场混乱。
普通抽签推荐 random.org(真随机,公信力高)或菜鸟工具随机数生成器(中文界面友好)。如果需要在大屏幕上展示抽奖过程,可以选择带动画效果的随机转盘工具。打开工具后先检查页面是否有「不重复」选项,这是抽签场景的关键功能。
在随机数生成器中填入:最小值(通常为 1)、最大值(参与人数 N)、生成数量(需要抽取的人数)。务必勾选「不重复」或「无放回」选项,否则可能出现同一个人被抽中两次的情况。部分工具还支持直接输入姓名列表,直接输出姓名而非编号,更直观。
在所有参与者(或其代表)能看到屏幕的情况下点击「生成」按钮,立即截图保存结果。random.org 还会提供结果的永久链接,可以发到群里让所有人自行核验。这一步的公开性是保证公平性的关键,不要事后才公布结果。
将生成的随机数字对照编号名单,确认对应的人员。如果使用的是直接输入姓名的工具,则直接宣布结果即可。建议把结果截图和名单对照表一起保存,如有争议可随时查阅。
最常见的坑是忘记勾选「不重复」,导致同一个号码出现两次,现场尴尬。另一个常见问题是范围设置错误——如果有 35 人但最大值设成了 34,第 35 号永远不会被抽到,这是对参与者的不公平。还有一点:不要在生成结果之前就把工具参数截图发出去,因为有人可能会质疑你在截图后又重新生成了一次——正确做法是先公开参数,当众点击生成,再截图。
Python 提供了两个随机数模块,用途截然不同。random 模块基于 MT19937,速度快但不适合安全场景;secrets 模块(Python 3.6+)基于操作系统 CSPRNG,专为密码学设计。一个非常常见的错误是用 random 生成密码或 Token——这在生产环境中是安全漏洞。
import random
import secrets

# ✅ 普通用途:抽签、模拟实验(可设种子复现)
random.seed(42)  # 固定种子,实验可复现
numbers = random.sample(range(1, 36), 5)  # 从1-35不重复抽5个
print(numbers)  # 如 [7, 23, 1, 31, 14]

# ✅ 密码学用途:生成密码、Token(绝不能用 random)
token = secrets.token_hex(32)   # 生成64位十六进制随机Token
password = secrets.token_urlsafe(16)  # 生成URL安全的随机密码
pin = secrets.randbelow(1000000)  # 生成6位随机PIN码(0-999999)

# ❌ 错误示范:用 random 生成密码(不安全!)
# bad_password = ''.join(random.choices('abcdef123', k=8))  # 勿用
JavaScript 的 Math.random() 是最常被误用的随机函数之一。它的实现因浏览器而异,V8 引擎使用 xorshift128+ 算法,虽然统计质量不错,但不是密码学安全的。生成密码、Token 或任何安全敏感的随机数时,必须使用 Web Crypto API 的 crypto.getRandomValues()。
// ✅ 普通用途:生成指定范围随机整数
function randomInt(min, max) {
  return Math.floor(Math.random() * (max - min + 1)) + min;
}
console.log(randomInt(1, 100)); // 1到100之间的随机整数

// ✅ 密码学用途:crypto.getRandomValues(浏览器/Node.js均可用)
function secureRandomInt(min, max) {
  const range = max - min + 1;
  const bytesNeeded = Math.ceil(Math.log2(range) / 8);
  const maxValid = Math.floor(256 ** bytesNeeded / range) * range;
  let value;
  do {
    const bytes = new Uint8Array(bytesNeeded);
    crypto.getRandomValues(bytes);
    value = bytes.reduce((acc, b) => acc * 256 + b, 0);
  } while (value >= maxValid); // 拒绝采样,消除模偏差
  return min + (value % range);
}

// ✅ 生成随机密码(密码学安全)
function generatePassword(length = 16) {
  const chars = 'ABCDEFGHJKMNPQRSTUVWXYZabcdefghjkmnpqrstuvwxyz23456789!@#$%';
  return Array.from(crypto.getRandomValues(new Uint8Array(length)))
    .map(b => chars[b % chars.length]).join('');
}
Java 的 java.util.Random 基于 LCG 变体,周期仅 2^48,且种子只有 48 位,已知输出后可在毫秒内破解。java.security.SecureRandom 则使用操作系统熵源,是 Java 中密码学场景的标准选择。注意:SecureRandom 的默认算法在不同 JVM 和操作系统上可能不同,生产环境建议显式指定算法。
import java.security.SecureRandom;
import java.util.Random;

// ✅ 普通用途(速度优先)
Random rng = new Random();
int num = rng.nextInt(100) + 1; // 1到100

// ✅ 密码学用途(安全优先)
SecureRandom secureRng = new SecureRandom();
byte[] token = new byte[32];
secureRng.nextBytes(token); // 生成256位随机字节(密钥材料)

// ✅ 生成安全随机整数(1到N范围)
int secureNum = secureRng.nextInt(100) + 1;
Go 语言的 math/rand 包是伪随机数,crypto/rand 包是密码学安全随机数,命名上已经做了明确区分。Rust 的 rand crate 提供了 ThreadRng(伪随机,自动从操作系统种子初始化)和 OsRng(直接使用操作系统熵源),两者都比 Java 的 Random 安全,但密码学场景仍应使用 OsRng。这两门语言在随机数 API 设计上比 Python/JavaScript 更清晰,踩坑概率相对较低。
这是最经典的安全漏洞。很多人写代码时会用当前时间戳(如 System.currentTimeMillis() 或 time.time())作为随机数种子,觉得「时间是变化的,所以种子也是随机的」。但问题在于:如果攻击者知道程序大概在什么时间运行(通常不难推断),只需枚举几分钟内的毫秒时间戳(约 60,000 个值),就能穷举出所有可能的随机数序列。2012 年 PHP 的一个彩票系统就因为这个漏洞被攻击者预测出了中奖号码。正确做法:让语言的随机数库自动管理种子,或使用操作系统提供的熵源初始化种子。
JavaScript 的 Math.random() 不是密码学安全的,但很多前端开发者在生成密码、验证码、Session Token 时直接使用它。V8 引擎的 Math.random() 实现(xorshift128+)已被研究人员证明可以通过观察足够多的输出值来预测后续值。如果你的网站用 Math.random() 生成了用户的重置密码链接 Token,理论上攻击者可以通过观察其他公开的随机数输出来预测这个 Token。请无条件使用 crypto.getRandomValues()。
很多人觉得不重复的随机数序列比允许重复的更随机,这是一个认知误区。真正的随机过程是允许重复的——掷骰子连续两次得到 6 是完全正常的随机结果,不是「不随机」的表现。「不重复随机数」实际上是「无放回随机抽样」,它是一种有约束的随机过程,在统计上与真正的独立随机有所不同。在抽签场景中,无放回抽样是正确的做法(因为一个人不应该被抽中两次);但在模拟独立随机事件时,强制不重复反而会引入偏差。
网上有大量声称能「预测彩票号码」的随机数工具或软件,这是彻头彻尾的骗局。彩票开奖使用独立的硬件随机设备,与任何在线随机数生成器没有任何关联。用随机数生成器选彩票号码,和随便写几个数字的中奖概率完全相同——每次开奖都是独立事件,历史结果不影响未来概率,这是概率论的基本原理。任何声称能提高中奖概率的工具都是在利用「赌徒谬误」欺骗用户。
很多开发者生成指定范围随机数时会写 random() % N,这会引入「模偏差」(Modulo Bias)。当随机数的取值范围不能被 N 整除时,某些值出现的概率会略高于其他值。比如用 0-255 的随机字节对 100 取模,0-55 出现的概率约为 2/256,而 56-99 出现的概率约为 1/256——差距约 1%,在大量样本下会显现出明显的不均匀性。正确做法是使用「拒绝采样」:生成随机数,如果它落在会造成偏差的范围内就丢弃重新生成,直到得到无偏差的结果。上面 JavaScript 代码示例中已经展示了这个技巧。
美国国家标准与技术研究院(NIST)发布的 SP 800-22 文档定义了 15 项统计检验方法,是评估随机数生成器质量的行业标准。这 15 项检验包括:频率检验(测试 0 和 1 的比例是否接近 50%)、块内频率检验、游程检验(测试连续相同值的长度分布)、最长游程检验、矩阵秩检验、离散傅里叶变换检验、非重叠模板匹配检验、重叠模板匹配检验、通用统计检验、线性复杂度检验、序列检验、近似熵检验、累积和检验、随机游走检验和随机游走变量检验。
NIST 提供了这套检验的官方 C 语言实现,可以免费下载使用。对于普通用户,不需要自己跑这些检验——主流的随机数生成器(MT19937、CSPRNG 等)都已经通过了这套检验。这套工具主要用于评估自研随机数生成器或不知名工具的质量。
TestU01 是由蒙特利尔大学开发的随机数检验库,比 NIST SP 800-22 更严格,包含 Crush、BigCrush 等一系列检验套件。BigCrush 包含约 106 项检验,能发现 NIST 检验无法发现的细微统计缺陷。MT19937 能通过 Crush 但在某些 BigCrush 检验中会失败(这正是它不适合密码学的原因之一)。如果你在评估一个新的随机数生成器算法,TestU01 的 BigCrush 是目前最严格的公开检验工具。
对于普通用户,有几个简单的方法可以粗略判断随机数质量。第一,生成 1000 个 1-10 之间的随机数,统计每个数字出现的次数,如果某个数字出现次数超过 150 或少于 50,可能存在问题(期望值约 100,正常波动范围约 ±30%)。第二,生成大量随机数并画散点图,如果出现明显的条纹或规律性图案,说明随机质量差(这正是 LCG 的典型缺陷)。第三,生成随机数序列并计算相邻两个数的相关系数,高质量随机数的相关系数应接近 0。这些方法不能替代正式的统计检验,但能快速发现明显的质量问题。
这个问题的答案是「取决于实现方式」。随机数生成器本身只是产生随机数的工具,抽奖的公平性还取决于:参与者名单是否完整且无重复、随机数的范围是否与参与者数量完全对应、是否有人能在生成前知道结果(比如提前看到种子)、结果是否在公众监督下生成。一个高质量的随机数生成器配合透明的操作流程,可以实现统计意义上的公平抽奖。但如果操作者在生成后「不满意」又重新生成,那再好的随机数生成器也救不了这次抽奖的公信力。
正规的大型抽奖活动通常采用「承诺-揭示」协议来保证公平性:在抽奖前公布随机数生成的参数(包括种子的哈希值),抽奖后公布完整种子,任何人都可以用相同的参数重新运行随机数生成器来验证结果。这种方式的关键在于:种子在抽奖前已经固定(通过哈希承诺),但在结果公布前没有人知道具体值,因此无法预先知道结果。random.org 的「第三方抽奖」功能也提供了类似的可审计机制,每次抽奖都有唯一的审计 ID,可以事后核验。
正规彩票(如中国福利彩票、体育彩票)的开奖使用专用的硬件随机设备,经过公证机构监督,与任何在线随机数生成器没有关联。这些设备通常采用物理随机过程(如气球抽号机的气流随机性、电子摇号机的硬件噪声),并在公证人员和媒体的监督下操作,结果实时直播。用任何在线随机数生成器「预测」彩票号码,在概率上与随便选号完全等价——每期开奖都是独立事件,任何号码组合的中奖概率相同,历史数据对未来结果没有预测价值。这是概率论的基本原理,不因「热号」「冷号」分析而改变。
手机上使用随机数生成器最方便的方式是直接用浏览器访问 random.org 的移动版——它自适应手机屏幕,功能完整,无需安装 App。如果需要原生 App,iOS 上「随机数生成器」类 App 数量较多,选择时注意查看是否声明了随机算法类型;Android 上同样如此。需要注意的是,手机 App 的随机数质量参差不齐,部分 App 使用了质量较低的算法,建议优先选择有明确算法说明的工具。对于密码生成需求,iOS 内置的「密码」App(设置→密码)和 Android 的 Google 密码管理器都使用系统级 CSPRNG,是手机上最安全的密码生成方案,无需安装第三方 App。
随机转盘类 App 在手机上体验更好,适合课堂互动和小型抽奖场合。这类 App 通常使用 Math.random() 或等价的伪随机数,对于日常抽签完全够用。选择时建议优先选择无广告或广告较少的版本,避免在重要场合被弹窗打断。
桌面端用户直接用浏览器访问在线工具是最便捷的方式,不需要安装任何软件。random.org 的桌面版功能最完整,支持整数、小数、序列、彩票号码、骰子、扑克牌等多种随机对象的生成。对于开发者,命令行工具更高效:Linux/macOS 可以用 od -An -N4 -tu4 /dev/urandom 直接从系统熵源读取随机数;Python 一行代码 python3 -c "import secrets; print(secrets.randbelow(100)+1)" 即可生成密码学安全的随机整数。Windows 用户可以用 PowerShell 的 Get-Random 命令,或安装 Python 后使用上述方法。
如果需要批量生成大量随机数(比如为数据库测试生成百万条随机数据),在线工具通常有速率限制,建议使用本地的编程语言库。Python 的 random 模块每秒可生成约 1000 万个随机整数,完全能满足大多数批量需求;如果需要更高速度,numpy 的随机数生成器(基于 PCG64 算法)性能更高,每秒可生成数亿个随机数。
另外,本站也提供随机数生成器 App,支持 iOS 和 Android,内置多种随机模式,欢迎下载体验。
以下数据来自搜索引擎相关搜索(近 30 天印象量),按搜索意图归组,帮你了解「随机数生成器」这个话题下真实的用户需求分布。
数据来源:搜索引擎相关搜索(Bing 站长工具),近 30 天印象量,仅供参考,实际数据以平台最新统计为准。
从 MT19937 的状态矩阵到高维均匀性,讲清楚为什么它在游戏和科学计算中几乎无可替代,以及它在密码学上的致命弱点。
从 Debian OpenSSL 漏洞到 PHP 彩票系统被破解,真实案例告诉你「随机数不够随机」的代价有多大。
用决策树帮你判断每个随机数使用场景应该选哪个模块,附完整代码示例和常见错误对比。
以上为用于说明内容分工的虚拟角色,不代表真实履历或机构背景。本站内容以公开技术文档与实测为准,暂无法确认的具体数据不臆造。
会重复,这是正常的随机行为。真正的随机过程是允许重复的——就像掷骰子连续两次得到 6 完全正常。在 1-100 范围内生成 10 个随机数,根据生日悖论,出现至少一次重复的概率约为 65%,这不是工具的问题,而是概率的本质。
如果你的场景需要不重复的随机数(比如抽签),应该使用工具的「不重复」或「无放回抽样」功能,而不是普通的随机生成。大多数主流在线随机数生成器都提供这个选项,勾选后生成的序列中每个值只会出现一次。
技术说明:不重复随机数的生成通常通过 Fisher-Yates 洗牌算法实现,先生成完整序列再随机打乱,时间复杂度为 O(n),对于几百到几千个元素的范围完全没有性能问题。
种子(Seed)是伪随机数生成器的初始输入值,决定了整个随机数序列。相同种子加相同算法,每次运行都会产生完全一样的序列——这叫做「可复现性」。比如用 Python 的 random.seed(42) 设置种子后,无论在哪台电脑上运行,random.random() 的前几个输出值都是固定的(约 0.6394、0.0250、0.2759……)。
种子的实际用途:① 科学实验复现——发表论文时公布种子,其他研究者可以完全重现你的随机数据;② 游戏存档——用种子记录随机地图的生成参数,玩家可以分享「地图码」;③ 调试——固定种子让随机行为可预测,方便找 Bug。
种子的安全风险:在密码学场景中,如果种子可以被猜到(比如用了时间戳),整个随机数序列就可以被预测。因此密码学场景必须使用操作系统自动管理的不可预测种子,绝不能手动指定。
对于日常抽签、抽号等低敏感场景,主流在线随机数生成器是安全的。random.org 在其隐私政策中说明会记录请求日志(包括 IP、请求参数、时间戳)用于系统运营和防滥用,但不会出售用户数据。这对于普通使用场景完全可以接受。
但如果你需要生成密码、API 密钥、加密密钥等安全敏感的随机数,强烈建议使用本地生成方案:浏览器的 crypto.getRandomValues() 完全在本地运行,不发送任何数据到服务器;Python 的 secrets 模块、Java 的 SecureRandom 同样完全本地化。本地 CSPRNG 不仅隐私更好,随机质量也达到密码学标准,是密码场景的最佳选择。
判断标准:如果生成的随机数「泄露了也没关系」(比如抽签结果),用在线工具没问题;如果生成的随机数「必须保密」(比如密码、密钥),用本地工具。
理论上限取决于算法和实现。梅森旋转算法(MT19937)的周期为 2^19937-1,理论上可以生成极大范围的整数,但实际上受限于计算机的整数表示范围(通常为 64 位,即约 ±9.2×10^18)。
主流在线工具的实际限制:random.org 的整数生成器支持 -1,000,000,000 到 1,000,000,000(即 ±10^9);浮点数生成器支持 0 到 1 之间的小数,精度通常为 15-17 位有效数字(IEEE 754 双精度浮点数的精度上限)。如果需要超出这个范围的大数,可以使用 Python 的 secrets.randbelow(n) 函数,n 可以是任意大的整数(Python 原生支持任意精度整数)。
实际建议:绝大多数使用场景(抽签、密码生成、数据模拟)都不需要超过 10^9 的范围。如果确实需要大数,建议使用编程语言的随机数库而非在线工具。
不能,这是一个常见的误解。彩票开奖使用独立的硬件随机设备,在公证人员监督下操作,与任何在线随机数生成器没有任何关联。用随机数生成器选彩票号码,和随便写几个数字的中奖概率完全相同——每次开奖都是独立事件,历史结果不影响未来概率。
「热号」「冷号」分析同样无效。某个号码连续多期未出现,不代表它「欠债」了、下期更可能出现——这种想法叫做「赌徒谬误」,是概率论中最经典的认知偏差之一。每期开奖时,每个号码的出现概率是相同的,与历史完全无关。
市面上声称能「提高中奖概率」的随机数工具或软件均不可信。用随机数生成器选号的唯一价值是避免人为选号时的心理偏差(比如很多人不愿选连续数字),但这对中奖概率没有任何影响。请理性对待彩票,量力而行。
取决于场景,没有绝对的「更好」。真随机数不可预测、不可复现,来自物理过程,适合密码学、重大公开抽奖等高安全或高公信力场景;伪随机数速度快(通常比真随机快 100-1000 倍)、可复现,适合游戏、数据模拟、科学计算等需要大量随机数或可复现性的场景。
日常场景选型建议:班级抽签、抽奖号码——高质量伪随机数完全够用,用 random.org 或菜鸟工具随机数生成器即可;密码生成——必须用 CSPRNG(crypto.getRandomValues() 或 Python secrets),不能用普通伪随机;科学实验模拟——用伪随机数并设置固定种子保证可复现;大型公开活动抽奖——推荐真随机数(random.org),公信力更高;游戏开发——伪随机数,速度和可复现性都需要。
一个简单的判断标准:如果「被人猜到随机数」会造成损失(经济损失、安全风险),就用 CSPRNG 或真随机;否则高质量伪随机数就够了。
本站内容以公开技术文档与实测经验为准,不提供任何彩票预测、密码破解或未授权资源入口。请遵守当地法律法规,理性使用随机数工具。
读完这篇指南,你应该已经对随机数生成器有了系统的认识。最后用一个简单的决策框架帮你快速定位:如果你是普通用户,只是偶尔需要抽签、抽号、随机排列顺序,任何主流的在线随机数生成器都能满足需求,random.org 是最稳妥的选择,菜鸟工具随机数生成器是中文界面最友好的选择;如果你需要生成密码或任何安全敏感的随机数,使用浏览器内置的基于 crypto.getRandomValues() 的密码生成器,或者直接用操作系统的密码管理器;如果你是开发者,记住一条铁律:普通随机用 random/Math.random(),安全场景用 secrets/crypto.getRandomValues()/SecureRandom,永远不要混用。
关于工具的选择,不必过度追求「真随机」。对于 99% 的日常使用场景,高质量的伪随机数(MT19937 或更好的算法)在统计上已经足够公平,与真随机数的差异在实际应用中几乎无法察觉。真正需要真随机数的场景只有两类:密码学(但这时候应该用 CSPRNG 而非在线真随机服务)和需要极高公信力的公开抽奖(这时候 random.org 的可审计机制是核心价值,而非真随机本身)。
| 用户类型 | 推荐工具 | 核心理由 |
|---|---|---|
| 普通用户·抽签抽号 | random.org / 菜鸟工具随机数生成器 | 够用、公信力高、操作简单 |
| 职场人·密码生成 | 基于 crypto.getRandomValues() 的本地工具 | 密码学安全、不上传数据 |
| 学生·数据模拟 | Python random 模块(设固定种子) | 可复现、速度快、免费 |
| 开发者·安全场景 | Python secrets / Java SecureRandom | CSPRNG 级别,语言内置零依赖 |
| 游戏开发者 | MT19937(各语言默认 random) | 速度快、可复现、统计质量好 |
| 大型活动主办方 | random.org(带审计链接) | 真随机 + 可公开核验,公信力最强 |
最后提醒一点:工具本身只是手段,操作流程的透明度同样重要。再好的随机数生成器,如果操作者在背后偷偷重新生成了几次才公布结果,公平性依然归零。让参与者当场见证生成过程、截图存档、提供可验证链接——这些习惯比纠结「真随机还是伪随机」更有实际价值。
无论是日常抽签、密码生成还是开发者选型,本站提供完整的工具推荐与教程支持。